本周完成 agent-level credit assignment 候选基线的初步筛选,并尝试复现 C3。
复现检查显示,当前公开仓库尚缺少关键脚本且训练配置与论文不完全对应,因此先明确其可复现边界,再调整下一阶段的问题选择。
本周清单
- 初步完成 baseline 选取:C3
- 启动 C3 复现与仓库核验
- 精读 C3,比较不同粒度的 counterfactual credit assignment
- 寻找衡量计算开销的 metric
一、初步完成 baseline 选取:C3
这一阶段的一个 motivation 是寻找更好的 cost-performance trade-off。当前 agent-level credit assignment 方法大多带有显式介入:例如 SHARP 用 Shapley value 估计单个 agent 的边际贡献。
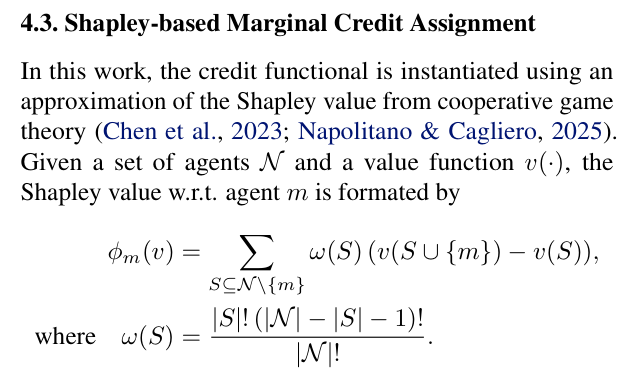
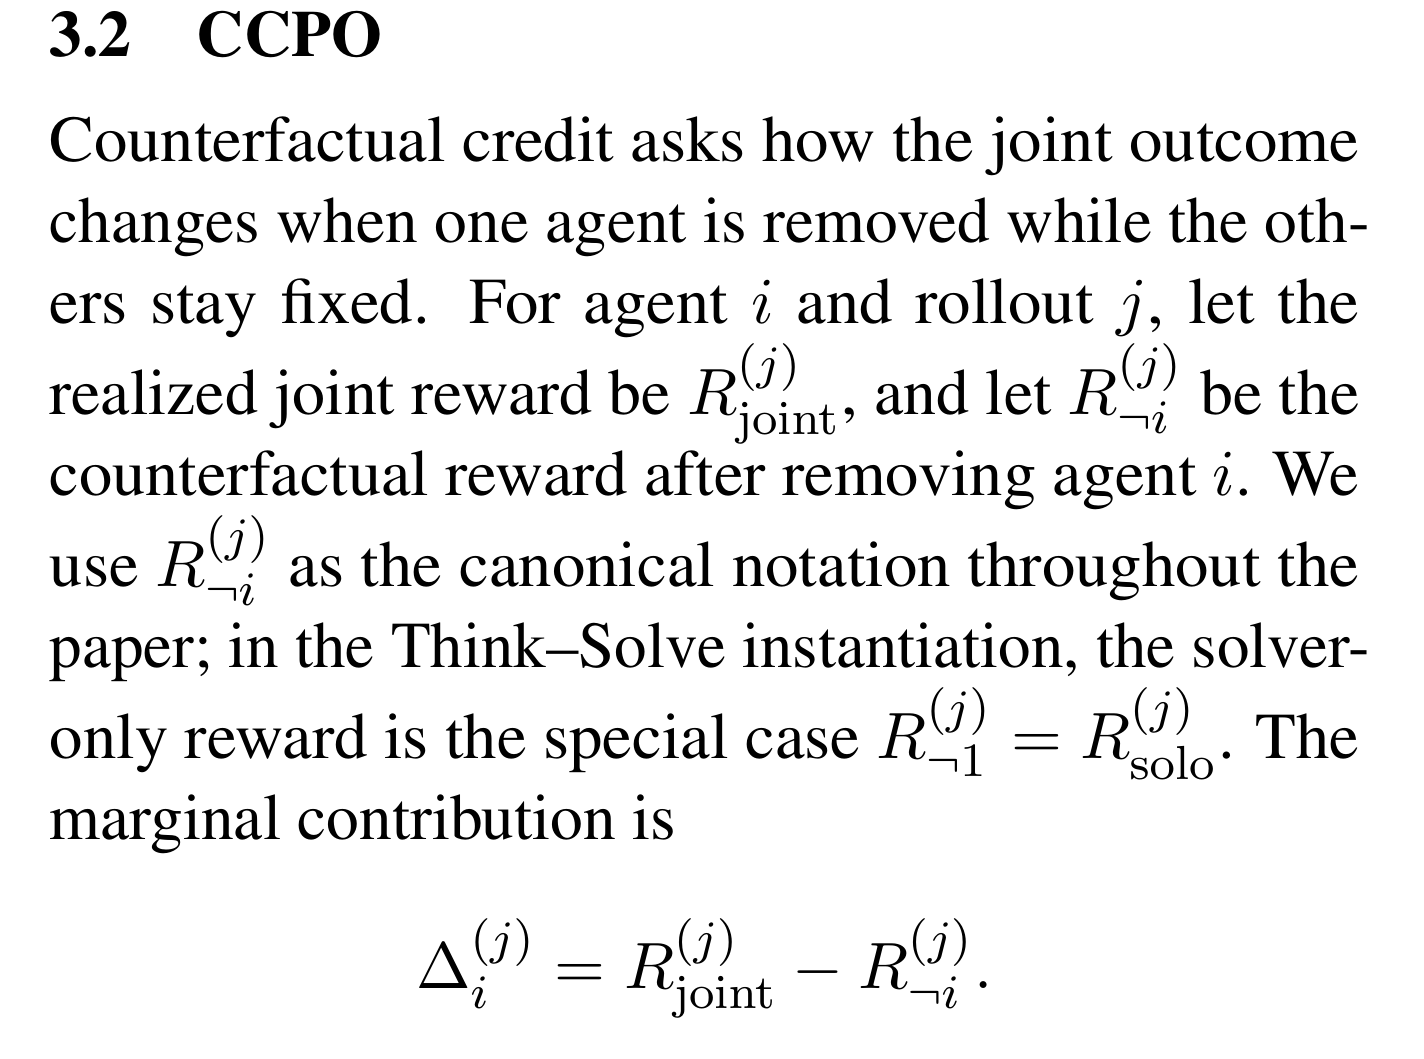
CCPO 和 C3 都利用 counterfactual,但介入粒度不同。CCPO 的做法是 mask 掉一个 agent 后重新进行 rollout,相当于直接考察移除该 agent 后的团队表现;原文讨论的重点似乎是 dual-agent 场景,例如 thinker 与 solver 的有无组合。
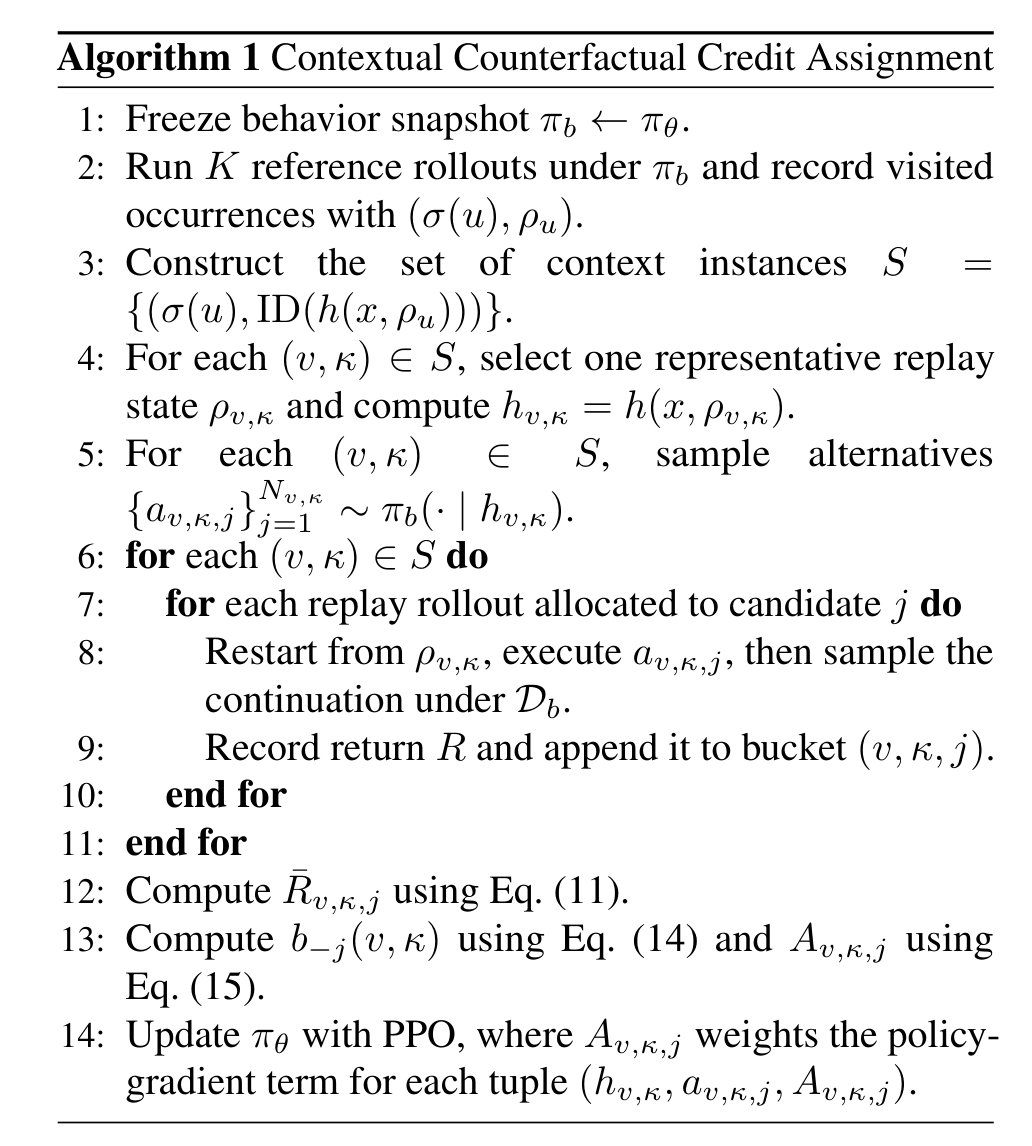
C3 则固定当前上下文,在 step level 替换某一条 message 来构造 counterfactual。相较于 whole-agent removal,它更接近对已完成轨迹中特定通信事件的局部归因。
二、C3 复现与当前边界
和盛天师哥讨论后,我先尝试复现 C3 的公开代码仓库,目标是核验它在 MATH500、GSM8K 等 benchmark 上的分数和运行链路。
检查发现,当前仓库缺少 scripts/data/ 与 scripts/models/;README 提到的 scripts/models/download_models.sh 也不存在。同时,现有训练脚本与论文中的配置并不完全一致,因此暂时无法从公开 checkout 建立一条可与论文结果严格对应的训练路径。
我已向作者邮件询问。作者回复称近期会对仓库进行较大规模维护,包括补充缺失文件、整理训练脚本与配置;但公开更新的具体时间尚不明确。基于这一状态,C3 仍可作为方法与估计粒度的研究参照,却不适合作为当前阶段可直接复现、并用于 cost-performance 对比的主基线。
因此,先不把这一问题绑定在 C3 的复现进度上,转而继续寻找更可验证的研究 gap。
三、下一步
- 重新聚焦 motivation 与可执行 baseline:考察 agent 广播、通信媒介与通信方式;例如在 latent space 直接传递 hidden state、为不同 policy 保留差异化上下文,以及动态内存与显存分配。
- 研究对应 method,明确通信上下文保留、异构 agent 与 agent 数量变化带来的建模约束。
- 将 Dr.MAS 纳入 baseline 候选,并与新的研究问题共同评估。