本周筛选 agent-level credit assignment baseline,重点核对 COSAC、DAE 与 COMA 的训练信号、反事实形式和额外成本。
同时尝试把 fixed-trace implicit counterfactual 写成事件级 trace,并明确 tool return 与下游消息可能造成的信息泄漏。
本周清单
- 筛选高质量 agent-level credit assignment baseline
- 寻找 fixed-trace implicit counterfactual 相关文章
- 整理下一步 baseline 选择
一、筛选高质量 agent-level credit assignment baseline
1.1 8.10 COSAC
关注点在于文章是否把同一个团队结果映射为具体 agent 的边际、反事实或可加总贡献。
目前找到了一个可直接训练的 agent-level policy-gradient baseline:COSAC。
COSAC 的核心 method 是在固定已实现 prefix 的条件下,对 focal agent(中心智能体或理解为当前 focus 的智能体)的动作进行当前策略下的反事实边际化,并把下游策略被该动作改变的部分作为 indirect effect。
在 rollout batch 上进行一次岭回归,来拟合团队奖励的 per-agent additive decomposition,然后从当前策略生成一个 fictitious continuation,计算每个智能体的反事实 advantage。
这篇文章存在的 gap 也就是它的 additive surrogate。
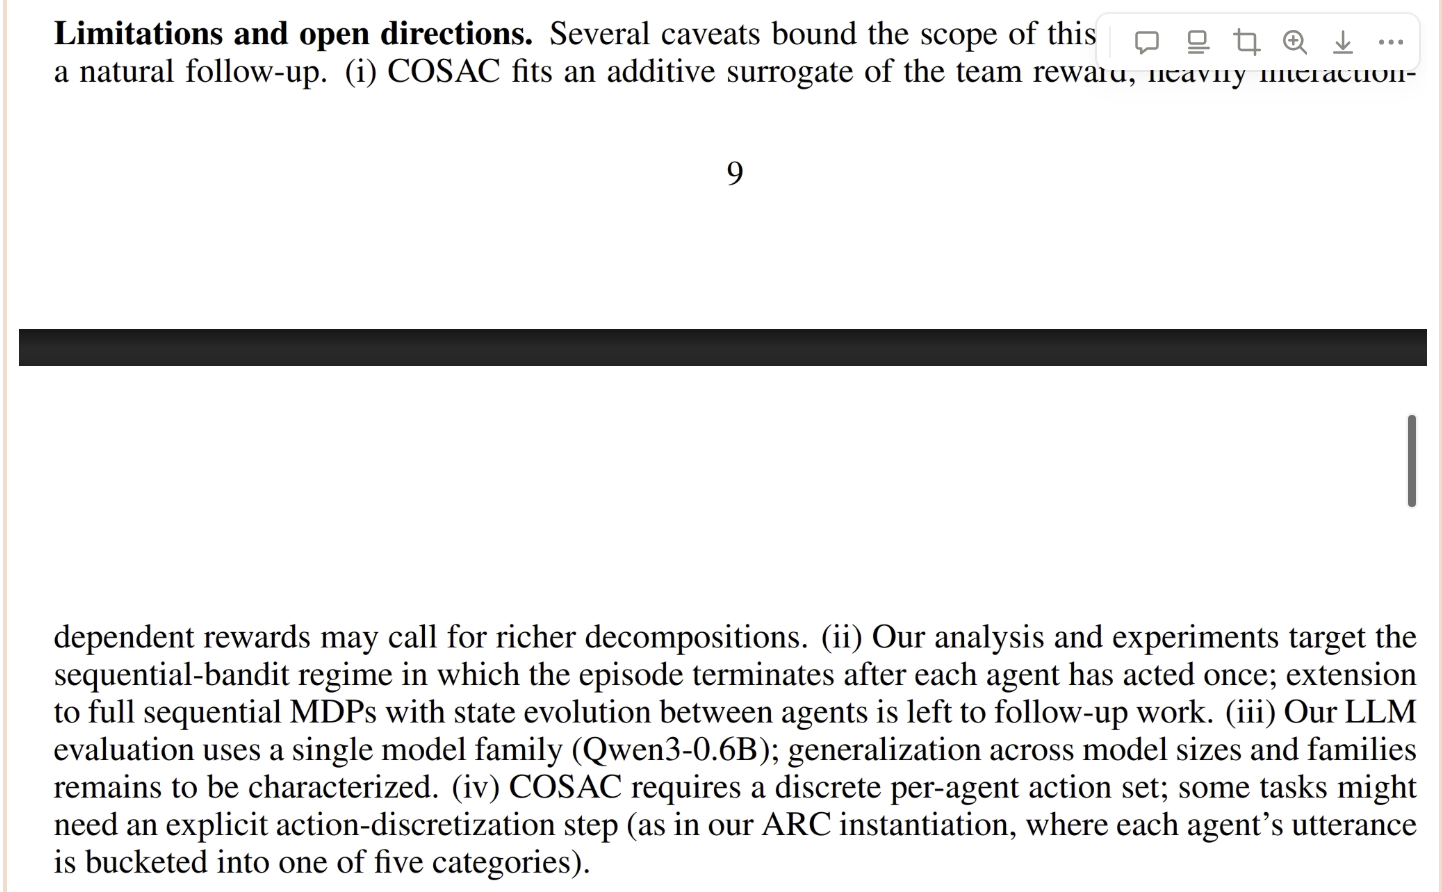
这种纯加性的估计可能会导致 LLM action 在实验中被离散化:原文的局限性说明指出,COSAC 需要离散的 per-agent action set;在 ARC 实验中,每个 agent 的 utterance 被划分为五类。但是我感觉这个说法不是很 convincing,原文说强交互奖励可能需要更丰富的 decomposition,但是他都使用岭回归估计了在自变量交互(共线性)大的情况下已经是优于朴素的线性回归(最小二乘法回归)了,还要怎么拓展更丰富的 decomposition 呢?有待学习了解。想更进一步的话应该就要在这个团队 reward 拟合的方式上做文章,不要把团队期望奖励近似为 per-agent 的加性分解。
但是还有一个很不利好的点就是如果选择这篇作为 baseline 的话,那么就要复现文章对于某 agent 的动作进行当前策略下的反事实边际化,而反事实比较扯,非常难做,这种 counterfactual 在现有的卡的场景下做实验非常局限。而现在面临的一个很现实的痛点就是好像 agent level 的 CA 基本都会用同一个团队结果来求某个 agent 的边际和反事实贡献,所以很 naive 但是很自然的一个想法就是去做一个不要反事实或者引入中心 critic 这种高成本的方法。这也是我的 motivation 之一。
更关键的是,进一步核验后没有找到足够可靠的正式发表、可核验原文和公开实现证据,AI 检索给出的论文条目或方法摘要只能作为搜索线索,不能直接成为 related work 证据。
需要找正式高水平 venue、原文可逐项核验、代码/artifact 可用的文章作为 baseline。
1.2 8.13 DAE
Difference Advantage Estimation for Multi-Agent Policy Gradients 正式发表于 ICML 2022,有作者代码和 MIT License,是这一轮筛选中质量、可核验性和 agent-level 输出较为匹配的工作。
核心 idea: DAE 学习 centralized reward network,并在固定其他 agent 动作时,对 focal agent 的有限离散动作按当前策略做边际化:
再用实际结果减去这个 focal-agent baseline,为每个 agent 产生独立 advantage。候选动作只经过 reward network forward,不需要为每个动作重跑环境。
1.3 8.14 COMA:经典 per-agent counterfactual 锚点
Counterfactual Multi-Agent Policy Gradients 正式发表于 AAAI 2018。COMA 的 agent-specific advantage 为
它固定其他 agent 的动作,只对 focal agent 的动作求策略期望,是经典的 per-agent counterfactual credit。centralized critic 可以在一次 forward 中给出 focal agent 所有离散动作的 ,不需要重跑环境。
启发: counterfactual 不一定等于重新 rollout,critic 内部的动作边际化也能产生反事实 baseline。
二、寻找 fixed-trace implicit counterfactual 相关文章
2.1 whole-agent removal 难以落地
由于 whole-agent removal 这种反事实难以落地,所以只能退而求其次去利用反事实的思路来做一些 implicit counterfactual 的思路。
agent-level credit 最直观的 estimand 显然是“把 agent 从系统中拿掉,再看 team reward 下降多少”。但 whole-agent removal 会改变 topology、history、tool use、环境状态和最终答案,因此必须从分支点重新 rollout。
如果一条 trace 有 个 agent,最朴素的 leave-one-agent-out 至少要额外生成 条反事实轨迹;一旦考虑 coalition 或 Shapley,成本还会继续增长。对现有算力和训练预算来说,这类显式系统级反事实无法作为主要 baseline 落地。
但是可以利用 counterfactual 的思路,在已经完成的 trace 上,对某个 agent/message 的输入内容做 deterministic mask,再让冻结 scorer 做 teacher-forced forward,把它限制成模型输入层面的 implicit counterfactual。看在固定其余已观测字段的时候,scorer 对 focal agent 内容是否敏感。
2.2 对应的 trace
尝试把 trace 写成事件级结构:
其中 是 agent, 是 role/event type, 是 message, 是 tool call 及其参数, 是已经发生的 tool return/observation, 是最终答案。
对目标 agent , 一次 mask 它在这条 trace 中的 全部 message 和全部 tool-call 参数,保留 agent id、role、事件位置以及“原本有一个事件”的标记。其他 agent 的消息、已经发生的 tool return/observation、后续回复和最终答案固定为原始值。
但是 tool return、observation 和下游消息可能已经携带了被 mask 内容的信息。例如 agent 提交了一个 search query,即使 query 被遮蔽,search result 和后续 agent 的复述仍可能把它暴露出来。
三、to-do
继续寻找合适的 baseline。我觉得实在不行就选 C3 那篇,去优化他们 training 阶段的开销。
目前的备选:DAE、COMA(但是这俩都太老了,感觉完全没有说服力)、C3、SHARP。下周再看这两个,把 baseline 确定下来。